
本記事では、現役ウェブエンジニアの管理人が、サーバーレスで生成AIモデルを実行できる「Vultr Serverless Inference」について解説します。
利用可能な用途やAIモデル、料金体系、メリット・デメリットに加え、具体的な使い方がわかるようになりますので、ぜひ読んでみてください。
Vultr Serverless Inferenceとは
Vultr Serverless Inferenceは、クラウドプラットフォームのVultrが提供している、自身のサーバを構築することなく学習済み生成AIを実行できるマネージドサービスです。
カテゴリー別に様々なモデルが使え、本記事執筆時点では以下のようなカテゴリーとモデルが提供されています。
- Chat and reasoning(チャットと推論)
- DeepSeek V4.1 Flash 1017
- GLM 5.2
- GLM 5.3
- GLM 5.3 Flash
- MiMo V2.6 Flash
- MiMo V2.6 Pro
- MiniMax M3.1 Flash
- Muse Glimmer 30B
- Nemotron 3 Nano Omni
- Nemotron 3.5 Content Safety
- Qwen 3.8 27B
- Qwen 3.8 Flash Next
- Raon-1 mini (preview)
- Images(画像生成)
- Qwen-Image 2.1
- MiniMax H3
- MOSS-Image
- Z-Image Turbo
- Video(動画生成)
- MiniMax H3
- Music(音楽生成)
- ACE-Step 1.5
- MiniMax Music 3
- Speech(音声合成)
- AuK
- AuK-Flash
- Chatterbox
- Qwen 3 TTS 12Hz 1.7B
- Transcription(文字起こし)
- Granite Speech
- Qwen3-ASR 1.7B
- Voxtral Mini 4B Realtime
- Whisper Large V3 Turbo
- Alignment
- Aligner 1
- Embeddings(埋め込み)
- Qwen 3 Embedding 4B
- Rerank
- BGE M3
- Decisions(判断特化)
- Clef
- Clef Flash
- d3
- pplx-decider v1.2
Vultrは定期的にモデルの入れ替えをしているので、最新の提供モデル一覧は公式サイトをご確認ください。
Vultr Serverless Inferenceの料金
Vultr Serverless Inferenceの料金体系は、カテゴリー別の従量課金制です。固定費はかかりません。
どのカテゴリーのモデルを使うかによって課金対象が異なりますが、いずれも入力または出力の量に対しての課金です。また、同じカテゴリーでもモデルによって単価は異なります。
カテゴリー別課金対象一覧:
- Chat and reasoning(チャットと推論):入出力のトークン数。例:$0.15 / 1M tokens、$0.60 / 1M tokens
- Images(画像生成):出力画像のピクセル数。例:$0.02 / megapixel
- Video(動画生成):出力動画の秒数。例:$0.06 / second
- Music(音楽生成):出力音楽の秒数。例:$0.0002 / second
- Speech(音声合成):出力音声の秒数。例:$0.00028 / second
- Transcription(文字起こし):入力音声の秒数。例:$0.00000555 / second
- Alignment:入力音声の秒数。例:$0.0000333 / second
- Embeddings(埋め込み):トークン数。例:$0.05 / 1M tokens
- Rerank:トークン数。例:$0.05 / 1M tokens
- Decisions(判断特化):トークン数。例:$0.10 / 1M tokens
モデルごとの単価は変化することがあるので、最新情報はVultr公式サイトで確認ください。
Vultr Serverless Inferenceのメリット・デメリット
Vultr Serverless Inferenceを実際に使って筆者が感じたメリット、デメリットです。
メリット:GPUサーバの固定費なしでオープンモデルを使える
自身でVPSを構築してオープンモデルをホスティングする方法もありますが、最新GPUサーバは高額ですし、構築や管理の手間もかかります。また、モデルを使っていない間もサーバの固定費が発生してしまいます。
その点、Serverless InferenceならVultrの最新GPUサーバにホスティングされているモデルを必要な時のみ使うことができます。
デメリット:Vultrがホスティングしているモデルのみ利用可能
Vultrのサーバでモデルをホスティングしているので、ClaudeやChatGPTのような自社サーバに載せられないモデルは使えません。
提供モデルの性能では物足りないタスクの場合、ClaudeやChatGPTなどの商用フロンティアモデルを別途使う必要があるので、Vultr1社のみで完結しない可能性があります。
Vultr Serverless Inferenceの使い方
ここからは、Vultr Serverless Inferenceの具体的な使い方を解説します。
前提:Vultrアカウントの作成
Vultr Serverless Inferenceを使うには、Vultrのユーザアカウントを登録する必要があります。
もしまだVultrにアカウントを持っていない方は、以下のリンクから登録すると$300のクレジットがもらえます。$300あればVultr Serverless Inferenceのほとんどのモデルを無料で試すことができます(クレジットの有効期間は登録から30日間です)。
ユーザ登録の詳しいステップは以下の記事で解説しています。
関連記事: Vultr VPSを現役エンジニアがレビュー
Inferenceの作成
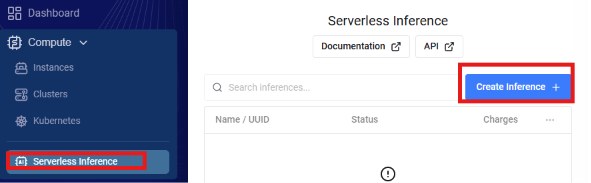
Vultrの管理画面の左サイドメニューから「Serverless Inference」メニューを選択し、表示された画面で「Create Inference」をクリックします。
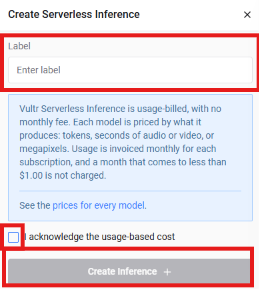
「Label」に名前を入力し、従量課金である旨に同意して「Create Inference」をクリックします。
AIモデルへのAPIリクエストの送信
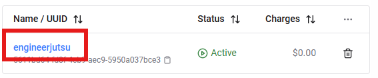
作成されたInferenceの名前をクリックして詳細画面に遷移します。
APIキーが表示されるので、コピーします。
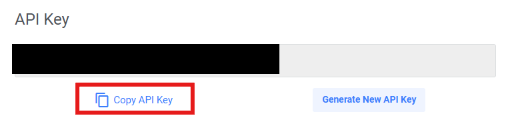
APIキーを環境変数(VULTR_INFERENCE_API_KEY)に設定します。
export VULTR_INFERENCE_API_KEY=your_api_keyAPIリクエストを送信します。APIはOpenAI APIとの互換性があるため、既存ツールやSDKをそのまま使うことができます。
本記事ではチャットカテゴリーモデルのDeepSeekを使いますが、他カテゴリーのモデルもAPI経由で利用できます。
curl https://api.vultrinference.com/v1/chat/completions \
  -H "Authorization: Bearer $VULTR_INFERENCE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-v4.1-flash-1017",
    "messages": [
      {
        "role": "system",
        "content": "Answer in one sentence."
      },
      {
        "role": "user",
        "content": "Why is the sky blue?"
      }
    ],
    "max_completion_tokens": 512
  }'
プロンプトに対する出力や、使用トークン数などを含むレスポンスが返ってきます。
{
    "id": "chatcmpl-cf1533df-8f7f-4c0e-a55f-7c3be9cc748b",
    "object": "chat.completion",
    "created": 1794883365,
    "model": "deepseek-v4.1-flash-1017",
    "system_fingerprint": "fp_41969099bd",
    "choices": [
        {
            "index": 0,
            "message": {
                "role": "assistant",
         "content": "The sky appears blue because air molecules scatter shorter-wavelength blue sunlight much more strongly than longer-wavelength red light, so blue light reaches our eyes from all directions.",
                "reasoning": "We need answer one sentence. Need comply. Explain Rayleigh scattering. One sentence."
            },
            "logprobs": null,
            "finish_reason": "stop",
            "native_finish_reason": "stop"
        }
    ],
    "usage": {
        "prompt_tokens": 41,
        "completion_tokens": 51,
        "total_tokens": 92,
        "prompt_tokens_details": {
            "cached_tokens": 0
        },
        "completion_tokens_details": {
            "reasoning_tokens": 16
        }
    }
}
まとめ:Vultr Serverless Inferenceでコスパ良く生成AIを使おう
Vultr Serverless Inferenceを使うと、生成AIモデルをサーバ構築の手間暇をかけずに実行することができます。
気になっているAIモデルを手軽に試したい時や、コストを抑えつつAIアプリを構築したい時に最適ですので、ぜひ試してみてください。